Stand: 25. September 2026
Eine künstliche Intelligenz kann Gedichte verfassen, Urlaubspläne entwerfen, Bilder erzeugen, Tumore auf Aufnahmen markieren oder verdächtige Kontobewegungen erkennen. Das wirkt manchmal, als säße hinter dem Bildschirm ein denkendes Wesen. Tatsächlich arbeitet dort eine sehr große mathematische Maschine: Sie hat aus Beispielen Muster gelernt und berechnet, welche Ausgabe zu einer Eingabe wahrscheinlich gut passt. Wie daraus erstaunlich überzeugende Antworten entstehen – und weshalb sie dennoch falsch sein können.
Ein angefangener Satz zeigt das Grundprinzip
Vervollständigen Sie im Kopf diesen Satz:
Wenn es draußen regnet, nehme ich einen …
Wahrscheinlich dachten Sie an „Regenschirm“. Vielleicht auch an „Mantel“. Kaum jemand würde „Kühlschrank“ einsetzen. Sie mussten dafür keine Grammatikregeln nachschlagen. Aus sehr vielen gelesenen und gehörten Sätzen haben Sie gelernt, welche Wörter in welcher Situation zusammenpassen.
Ein modernes Sprachmodell löst eine verwandte Aufgabe – allerdings nicht auf menschliche Weise. Es zerlegt Text in kleine Einheiten, verarbeitet den bisherigen Zusammenhang und berechnet für viele mögliche Fortsetzungen Wahrscheinlichkeiten. Dann wählt es eine davon aus. Anschließend wiederholt es denselben Vorgang mit der nun verlängerten Folge. Wortstück für Wortstück entsteht eine Antwort.
Das klingt zunächst nach einer besseren Autovervollständigung. Es erklärt aber noch nicht, weshalb ein System übersetzen, programmieren, zusammenfassen oder einen Einwand beantworten kann. Der entscheidende Unterschied liegt in der Größe, in den Trainingsdaten und darin, wie moderne Modelle Zusammenhänge darstellen. Wer diese Schritte versteht, erkennt sowohl die enorme Leistungsfähigkeit als auch die Grenzen heutiger KI.
Was bedeutet „künstliche Intelligenz“ überhaupt?
„Künstliche Intelligenz“ ist kein Name für eine einzelne Technik. Es ist ein Sammelbegriff für Computersysteme, die Aufgaben erledigen, für die Menschen typischerweise Fähigkeiten wie Wahrnehmung, Sprachverarbeitung, Planung, Mustererkennung oder Schlussfolgern benötigen.
Darunter fallen sehr unterschiedliche Systeme:
- ein Programm, das unerwünschte E-Mails erkennt,
- eine Kamera, die Gesichter oder Verkehrsschilder findet,
- ein Empfehlungssystem für Filme und Musik,
- ein Schachprogramm,
- eine Software zur Auswertung medizinischer Bilder,
- ein Sprachassistent oder ein großer Chatbot,
- ein Generator für Bilder, Musik oder Videos.
Diese Systeme funktionieren nicht alle gleich. Manche folgen von Menschen formulierten Regeln. Andere lernen statistische Muster aus Daten. Viele praktische Anwendungen kombinieren mehrere Verfahren, Datenbanken und klassische Software. Wenn heute im Alltag von „KI“ gesprochen wird, ist meistens maschinelles Lernen gemeint – und bei Chatbots speziell ein großes Sprachmodell.
Auch Fachleute verwenden keine einzige, weltweit unumstrittene Definition. Die OECD beschreibt ein KI-System vereinfacht als ein maschinenbasiertes System, das aus Eingaben ableitet, wie es Vorhersagen, Inhalte, Empfehlungen oder Entscheidungen erzeugt. Wichtig ist das Wort „ableitet“: Das gewünschte Verhalten wird nicht für jeden Einzelfall vollständig von Hand programmiert.
Der Unterschied zur klassischen Software
Bei einem herkömmlichen Programm schreibt ein Mensch möglichst genaue Anweisungen. Ein stark vereinfachtes Beispiel:
Wenn der Rechnungsbetrag über 10.000 Euro liegt, verlange eine zweite Freigabe.
Die Regel ist sichtbar. Der Computer führt sie immer gleich aus. Das funktioniert gut, solange sich die Aufgabe eindeutig in Regeln ausdrücken lässt.
Nun soll der Computer auf Fotos Katzen erkennen. Menschen könnten Regeln versuchen: Katzen haben zwei spitze Ohren, Schnurrhaare, Fell und vier Beine. Doch auch Füchse haben spitze Ohren. Auf manchen Bildern sieht man nur den Kopf. Eine schwarze Katze im Schatten hat kaum erkennbare Konturen. Eine Zeichnung sieht anders aus als ein Foto. Die vollständige Liste zuverlässiger Regeln würde praktisch unbeherrschbar.
Beim maschinellen Lernen dreht sich der Ansatz um. Menschen geben dem System viele Beispiele – etwa Bilder mit der Kennzeichnung „Katze“ oder „keine Katze“. Ein Trainingsverfahren verändert intern sehr viele Zahlen so lange, bis das Modell die Beispiele zunehmend richtig einordnet. Es lernt nicht die menschliche Definition einer Katze. Es findet mathematische Muster, die in den Trainingsdaten beim Unterscheiden helfen.
Das fertige Modell enthält also nicht einfach eine von Menschen geschriebene Katzenregel. Es enthält sehr viele angepasste Zahlenwerte. Diese heißen Parameter. Bei großen neuronalen Netzen können es Milliarden sein.
Drei Begriffe, die fast alles verständlicher machen
Viele Missverständnisse verschwinden, wenn drei Dinge getrennt werden:
- Das Trainingsmaterial: Beispiele, aus denen Muster gelernt werden – etwa Texte, Bilder, Tonaufnahmen oder Messwerte.
- Das Modell: die während des Trainings eingestellte mathematische Struktur mit ihren Parametern.
- Die Anwendung: das fertige Modell wird mit einer neuen Eingabe benutzt und erzeugt eine Ausgabe. Dieser Vorgang heißt Inferenz.
Eine anschauliche, wenn auch unvollkommene Metapher ist ein riesiges Mischpult. Das Training verstellt Milliarden Regler. Die Trainingsbeispiele verschwinden nicht unbedingt spurlos – Modelle können einzelne Inhalte teilweise auswendig lernen –, aber normalerweise speichert das System nicht jedes Dokument wie ein Archiv. Das Ergebnis ist vor allem ein Netz gelernter statistischer Beziehungen.
Bei der späteren Nutzung werden diese Regler normalerweise nicht für jede Frage neu eingestellt. Das Modell berechnet mit den bereits gelernten Einstellungen eine Antwort. Eine Unterhaltung mit einem Chatbot trainiert das Grundmodell deshalb nicht automatisch in Echtzeit weiter. Ob Eingaben gespeichert oder später für Verbesserungen genutzt werden, hängt vom Anbieter, Produkt und den gewählten Datenschutzoptionen ab.
Was ist ein neuronales Netz?
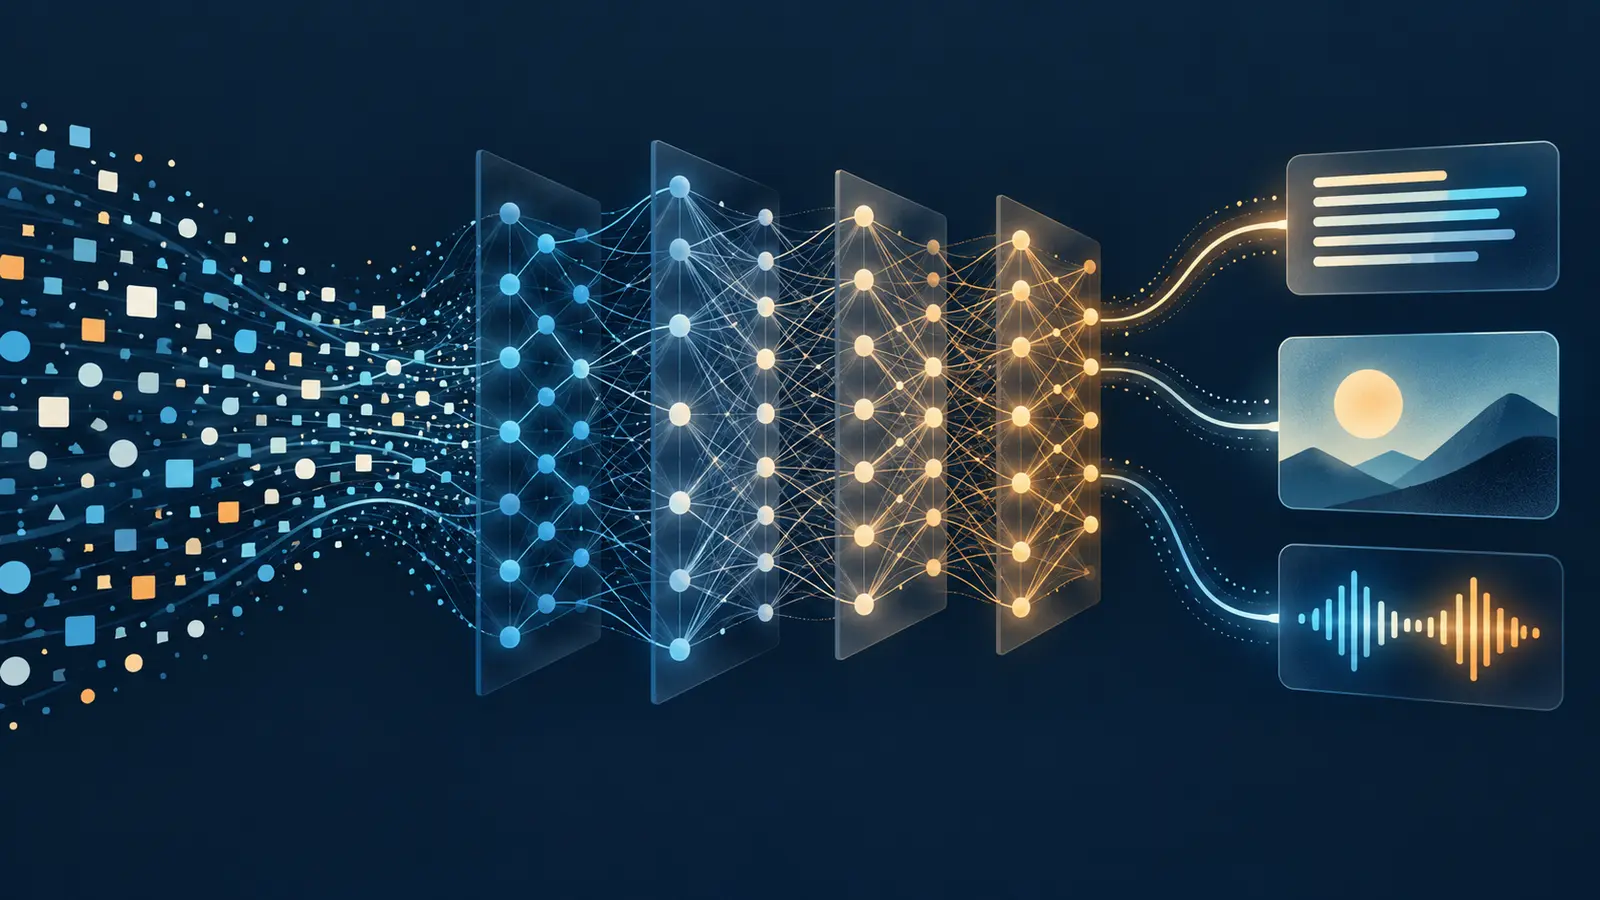
Der Begriff klingt biologischer, als die Technik ist. Ein künstliches „Neuron“ ist kein winziges Gehirn. Es ist eine Recheneinheit: Zahlen kommen hinein, werden unterschiedlich stark gewichtet, miteinander verrechnet und durch eine weitere mathematische Funktion geschickt. Das Ergebnis wird an die nächste Schicht weitergegeben.
Man kann sich ein Netz aus mehreren Ebenen vorstellen:
- Die Eingabeschicht erhält Daten, beispielsweise die Helligkeits- und Farbwerte eines Bildes.
- Viele Zwischenschichten kombinieren einfache Merkmale zu immer komplexeren Mustern.
- Die Ausgabeschicht liefert beispielsweise Wahrscheinlichkeiten für „Katze“, „Hund“ oder „anderes Tier“.
Die erste Ebene könnte auf einfache Kanten reagieren. Spätere Ebenen kombinieren Kanten zu Formen und Formen zu Fellmustern, Augen oder Ohren. Niemand muss festlegen, dass genau eine bestimmte Recheneinheit für „linkes Katzenohr“ zuständig ist. Die Darstellung verteilt sich meist über viele Teile des Netzes.
„Tiefes Lernen“ oder Deep Learning bedeutet im Kern, dass ein neuronales Netz viele Verarbeitungsschichten besitzt. Die Tiefe erlaubt es, komplexe Beziehungen aufzubauen. Sie macht das Modell zugleich schwerer durchschaubar: Selbst die Entwickler können bei großen Netzen nicht für jede einzelne Ausgabe vollständig erklären, welche internen Rechenschritte ausschlaggebend waren.
Wie das Training funktioniert: raten, Fehler messen, Regler verändern
Am Anfang sind die Parameter eines neuen Netzes weitgehend unbrauchbar eingestellt. Das Modell macht schlechte Vorhersagen. Dann beginnt ein oft millionen- oder milliardenfach wiederholter Kreislauf:
- Eingabe: Das Modell erhält ein Trainingsbeispiel.
- Vorhersage: Es erzeugt mit seinen aktuellen Parametern eine Ausgabe.
- Fehlermessung: Eine mathematische Fehlerfunktion vergleicht die Ausgabe mit dem Trainingsziel.
- Rückrechnung: Das Verfahren bestimmt, welche Parameter in welche Richtung verändert werden sollten, um den Fehler zu verkleinern. Dieser Schritt heißt Rückwärtsausbreitung oder Backpropagation.
- Kleine Korrektur: Die Parameter werden ein wenig angepasst.
Das ist eher ein systematisches Nachjustieren als ein Geistesblitz. Nach sehr vielen Beispielen sinkt der durchschnittliche Fehler. Das Modell soll dabei nicht nur die bekannten Aufgaben wiederholen, sondern das Gelernte auf neue Fälle übertragen. Diese Fähigkeit heißt Generalisierung.
Lernt ein Modell die Trainingsbeispiele zu genau auswendig und versagt bei neuen Daten, spricht man von Überanpassung. Deshalb werden Trainings-, Prüf- und Testdaten getrennt. Ein Schüler, der nur die Lösungen eines Übungsblatts auswendig kennt, hat das Rechenverfahren noch nicht verstanden. Für ein Modell gilt sinngemäß dasselbe – auch wenn „Verstehen“ bei Maschinen ein schwieriger Begriff bleibt.
Was ein Sprachmodell aus Text lernt
Beim Grundtraining eines großen Sprachmodells besteht die Übung vereinfacht darin, fehlende oder folgende Textteile vorherzusagen. Das System sieht sehr viele Textfolgen und versucht jeweils zu bestimmen, wie sie weitergehen. Die richtige Fortsetzung ist im Trainingsmaterial bereits vorhanden; daraus lässt sich der Fehler berechnen.
Diese scheinbar schlichte Aufgabe zwingt das Modell, überraschend viel Struktur abzubilden. Um ein Wort gut vorherzusagen, muss es Unterschiede zwischen Frage und Antwort, Vergangenheit und Zukunft, Singular und Plural oder Programmcode und Alltagssprache berücksichtigen. Für längere Passagen helfen auch interne Darstellungen von Gegenständen, Personen, Orten, Stilen und typischen Ursache-Wirkungs-Beziehungen.
Das Modell erhält jedoch kein kleines Lehrbuch mit einer garantiert wahren Weltbeschreibung. Es lernt aus seinen Daten, welche Zeichenfolgen und Konzepte zusammen auftreten. Darin stecken Fakten und Irrtümer, Wissenschaft und Werbung, hilfreiche Erklärungen und Vorurteile. Schon deshalb ist ein Sprachmodell keine Wahrheitsmaschine.
Tokens: Warum die KI keine Wörter sieht
Ein Sprachmodell verarbeitet Text nicht direkt als Wörter. Zunächst zerlegt ein sogenannter Tokenizer die Zeichenfolge in Tokens. Ein Token kann ein ganzes häufiges Wort sein, ein Wortteil, ein Satzzeichen oder in manchen Fällen nur ein einzelnes Zeichen.
Aus „unwahrscheinlich“ könnten beispielsweise mehrere Bestandteile entstehen. Häufige Wörter bleiben eher zusammen, seltene oder zusammengesetzte Wörter werden stärker zerlegt. Die genaue Aufteilung unterscheidet sich von Modell zu Modell und von Sprache zu Sprache.
Jedes Token erhält eine Nummer. Diese Nummer allein sagt noch nichts über Bedeutung aus. Das Modell übersetzt sie deshalb in eine lange Liste von Zahlen – einen Vektor. Während des Trainings werden solche Zahlendarstellungen so angeordnet, dass verwendungsähnliche Begriffe in bestimmten mathematischen Beziehungen zueinander stehen. Diese Darstellungen heißen Embeddings.
Das erklärt einen Teil der sprachlichen Flexibilität. Das System hantiert nicht nur mit einer starren Wörterliste. Es verarbeitet gelernte Beziehungen in einem hochdimensionalen Raum – also in viel mehr Richtungen, als Menschen zeichnen können.
Der Transformer: Worauf muss das Modell achten?
Die wichtigste Architektur hinter heutigen großen Sprachmodellen heißt Transformer. Sie wurde 2017 in der Forschungsarbeit „Attention Is All You Need“ vorgestellt. Ihr zentrales Werkzeug ist die sogenannte Selbstaufmerksamkeit, auf Englisch self-attention.
Nehmen wir den Satz:
Die Ärztin legte das Buch auf den Tisch, weil sie es später brauchte.
Um „sie“ und „es“ sinnvoll einzuordnen, muss das Modell Beziehungen zu anderen Satzteilen beachten. Selbstaufmerksamkeit berechnet, welche Tokens für die Verarbeitung eines bestimmten Tokens besonders wichtig sind. Mehrere Aufmerksamkeitseinheiten können gleichzeitig auf unterschiedliche Beziehungen reagieren: Satzbau, Bezugnahmen, zeitliche Abfolgen oder inhaltliche Nähe.
Das Wort „Aufmerksamkeit“ ist dabei eine Metapher. Das Modell konzentriert sich nicht bewusst. Es berechnet Gewichtungen. Trotzdem löste diese Technik ein wichtiges Problem: Viele Bestandteile eines Textabschnitts lassen sich zueinander in Beziehung setzen, und das Training kann stark parallelisiert werden.
Transformer bestehen nicht nur aus Aufmerksamkeit. Weitere Rechenschichten verarbeiten und verändern die Darstellungen, Zwischenergebnisse werden weitergereicht und normalisiert. Dieser Block wird vielfach hintereinandergeschaltet. Am Ende liefert das Modell für das nächste Token eine Wahrscheinlichkeitsverteilung.
Was beim Absenden einer Frage geschieht
Wenn jemand einen Chatbot fragt: „Warum ist der Himmel blau?“, geschieht vereinfacht Folgendes:
- Die Eingabe, Systemanweisungen und der noch berücksichtigte Gesprächsverlauf werden in Tokens zerlegt.
- Die Tokens werden in Zahlendarstellungen übersetzt und durch die vielen Schichten des Modells verarbeitet.
- Das Modell berechnet Wahrscheinlichkeiten für das nächste Token.
- Ein Auswahlverfahren bestimmt eine Fortsetzung. Nicht immer gewinnt starr das wahrscheinlichste Token; etwas kontrollierter Zufall kann Antworten abwechslungsreicher machen.
- Das ausgewählte Token wird an den bisherigen Text angehängt.
- Der Vorgang beginnt erneut, bis die Antwort abgeschlossen ist.
Der Regler, der häufig als „Temperatur“ bezeichnet wird, beeinflusst die Auswahl. Eine niedrige Temperatur bevorzugt stark die wahrscheinlichsten Fortsetzungen. Eine höhere Temperatur lässt auch weniger wahrscheinliche Möglichkeiten zu. Sie macht eine Antwort oft vielfältiger, aber nicht automatisch kreativer im menschlichen Sinn – und erst recht nicht wahrer.
Die Ausgabe wird also nicht als fertiger Absatz aus einer verborgenen Datenbank geholt. Sie entsteht schrittweise. Deshalb kann dasselbe Modell auf dieselbe Frage unterschiedliche Antworten liefern. Und deshalb kann ein Satz lokal sehr überzeugend weitergehen, obwohl seine zentrale Behauptung falsch ist.
Warum ein Textvorhersager zum hilfreichen Assistenten wird
Ein nur auf Textvorhersage trainiertes Grundmodell ist noch kein guter Chatbot. Es könnte eine Frage einfach mit einer weiteren Frage, einer erfundenen Forumsdiskussion oder einem unpassenden Textstück fortsetzen.
Deshalb folgt nach dem Grundtraining meist eine weitere Anpassung. Menschen verfassen Beispielantworten, bewerten Ausgaben oder ordnen mehrere Antworten nach Qualität. Das Modell lernt daraus, Anweisungen besser zu befolgen, hilfreicher zu formulieren und bestimmte schädliche Inhalte zu vermeiden. Bekannt wurde unter anderem das Verfahren „Reinforcement Learning from Human Feedback“, also bestärkendes Lernen aus menschlichen Rückmeldungen.
Moderne Anbieter verwenden unterschiedliche und weiterentwickelte Varianten. Das gemeinsame Prinzip bleibt: Menschen definieren durch Beispiele, Bewertungen, Regeln und Tests mit, welches Verhalten als erwünscht gilt. Die scheinbar rein automatische KI beruht daher auch auf viel menschlicher Arbeit.
Das Modell ist nicht die ganze Anwendung
Ein verbreiteter Irrtum lautet: Alles, was ein Chatbot ausgibt, müsse im Sprachmodell gespeichert sein. Tatsächlich bestehen moderne KI-Anwendungen häufig aus mehreren Bausteinen.
Ein Sprachmodell kann beispielsweise:
- eine Internetsuche auslösen,
- Dokumente aus einer freigegebenen Datenbank abrufen,
- einen Taschenrechner oder Programmcode verwenden,
- Kalender-, E-Mail- oder Unternehmenssysteme über Schnittstellen ansprechen,
- die gefundenen Informationen zu einer Antwort zusammenfügen.
Eine häufige Technik heißt Retrieval-Augmented Generation, kurz RAG: Passende Dokumentstellen werden zuerst gesucht und dem Modell als zusätzlicher Kontext gegeben. Das kann Antworten aktueller und überprüfbarer machen. Es beseitigt Fehler jedoch nicht automatisch. Die Suche kann unpassende Quellen liefern, das Modell kann sie falsch zusammenfassen oder eine Quelle überdehnen.
Wenn ein System eine Rechenaufgabe exakt löst, kann das daher bedeuten, dass das Sprachmodell selbst gerechnet hat – oder dass es einen Rechner benutzt hat. Für die Zuverlässigkeit ist dieser Unterschied wichtig.
Wie Bildgeneratoren, Spracherkennung und Empfehlungen funktionieren
Das Grundmuster „aus vielen Beispielen Beziehungen lernen“ findet sich auch außerhalb von Text. Die genaue Trainingsaufgabe ist jedoch anders.
Bildgeneratoren
Viele moderne Bildgeneratoren arbeiten mit Diffusionsmodellen. Beim Training werden Bilder schrittweise mit Rauschen überlagert. Das Modell lernt den umgekehrten Weg: Es soll aus einem verrauschten Zwischenzustand wieder eine etwas klarere Darstellung machen. Bei der Erzeugung beginnt es mit Rauschen und entfernt dieses in vielen Schritten. Eine Texteingabe steuert, welche Bildmerkmale dabei entstehen sollen.
Das Modell setzt nicht wie eine Collage einfach Bildschnipsel zusammen. Es erzeugt neue Pixelmuster aus gelernten statistischen Beziehungen. Trotzdem kann es Elemente aus Trainingsbildern nachahmen oder in seltenen Fällen stark ähnelnde Inhalte reproduzieren. Fragen zu Urheberrecht, Einwilligung und Herkunft der Trainingsdaten verschwinden daher nicht.
Sprach- und Tonsysteme
Eine Spracherkennung erhält die Schwingungen einer Aufnahme als Zahlen und lernt Beziehungen zwischen akustischen Mustern und Spracheinheiten. Ein Sprachgenerator löst die umgekehrte Aufgabe: Aus Text oder anderen Steuerinformationen entsteht eine Folge akustischer Merkmale, die anschließend in hörbaren Ton umgewandelt wird.
Empfehlungssysteme
Ein Empfehlungsmodell sucht Muster zwischen Nutzern, Inhalten und Reaktionen. Wer ähnliche Filme gesehen, ähnliche Musik übersprungen oder ähnliche Produkte gekauft hat, erhält möglicherweise ähnliche Vorschläge. Optimiert das System auf Klicks oder Verweildauer, lernt es allerdings nicht automatisch, was für Menschen gut ist. Es lernt zunächst, was die gewählte Kennzahl erhöht.
Warum KI Dinge erfindet
Ein Sprachmodell wird im Grundtraining dafür belohnt, eine plausible Fortsetzung zu erzeugen. Wahrheit und Plausibilität überschneiden sich oft – aber nicht immer.
Wird nach einem real klingenden Gerichtsurteil gefragt, kann das Modell ein Aktenzeichen in einem typischen Format erzeugen, selbst wenn dieses Urteil nie existierte. Die Bestandteile passen sprachlich gut zusammen. Eine interne Garantie, dass der genannte Fall in der Wirklichkeit existiert, folgt daraus nicht.
Solche selbstbewusst formulierten Falschangaben werden oft „Halluzinationen“ genannt. NIST verwendet dafür auch den sachlicheren Begriff confabulation. Die Fehler entstehen nicht, weil die Maschine lügen möchte. Eine Lüge würde Absicht voraussetzen. Das System erzeugt eine statistisch passende, aber sachlich falsche Ausgabe.
Zusätzliche Datenquellen, Werkzeugnutzung, bessere Trainingsmethoden und Prüfmechanismen können das Risiko senken. Vollständig beseitigt ist es nicht. Besonders riskant sind:
- konkrete Quellenangaben und Zitate,
- aktuelle Nachrichten oder Preise ohne Live-Zugriff,
- seltene Fachfragen,
- medizinische, rechtliche und finanzielle Entscheidungen,
- Berechnungen, wenn kein verlässliches Rechenwerkzeug benutzt wird.
Denkt oder versteht eine KI?
Die ehrliche Antwort hängt davon ab, was mit „denken“ und „verstehen“ gemeint ist.
Große Modelle können Informationen über mehrere Schritte verknüpfen, Analogien bilden, Programme entwerfen und interne Darstellungen verwenden, die weit über das stumpfe Wiederholen gespeicherter Sätze hinausgehen. Die Formel „nur Autovervollständigung“ unterschätzt deshalb, was aus sehr leistungsfähiger Vorhersage entstehen kann.
Genauso irreführend wäre aber die Behauptung, ein Chatbot verstehe die Welt wie ein Mensch. Er besitzt keinen menschlichen Körper, keine Kindheit, keine eigenen Sinneserfahrungen und keine verlässliche, fortlaufende Lebensgeschichte. Ob maschinelle Systeme jemals Bewusstsein besitzen können, ist eine offene philosophische und wissenschaftliche Frage. Für heutige allgemein verfügbare Sprachmodelle gibt es keinen belastbaren Nachweis eines subjektiven Erlebens.
Alltagssprache verführt zur Vermenschlichung. Ein Chatbot schreibt „Ich glaube“ oder „Ich freue mich“, weil solche Formulierungen in Gesprächen passen. Daraus folgt kein Glaube und kein Gefühl. Umgekehrt macht das Fehlen menschlichen Bewusstseins die Leistung nicht wertlos. Ein Taschenrechner fühlt ebenfalls nichts und kann dennoch nützlich sein.
Die sinnvollste Haltung liegt zwischen zwei Extremen: KI ist weder ein denkender digitaler Mensch noch ein bloßer Zufallsgenerator. Sie ist ein leistungsfähiges Modell gelernter Muster, dessen Fähigkeiten je nach Aufgabe erstaunlich – und dessen Fehler ebenso real – sein können.
Warum Daten zu Vorurteilen und blinden Flecken führen können
Trainingsdaten sind keine neutrale Kopie der Welt. Sie spiegeln wider, wer Texte veröffentlicht, welche Sprachen häufig vertreten sind, welche Gruppen häufiger fotografiert wurden und welche historischen Ungleichheiten in Entscheidungen stecken.
Ein Bewerbungsmodell, das aus früheren Personalentscheidungen lernt, kann alte Benachteiligungen übernehmen. Eine Bilderkennung kann bei Gruppen schlechter funktionieren, die in den Trainingsdaten unterrepräsentiert waren. Ein Sprachmodell kann verbreitete Stereotype reproduzieren, gerade weil sie verbreitet sind.
Entwickler können Daten prüfen, problematische Beispiele gewichten, Modelle nachtrainieren, Ausgaben testen und Schutzregeln einbauen. Doch Fairness lässt sich nicht allein technisch definieren. Menschen müssen entscheiden, welche Fehler besonders schwer wiegen und welche gesellschaftlichen Werte gelten sollen.
Darum ist die Frage nicht nur: „Wie genau ist die KI im Durchschnitt?“ Ebenso wichtig ist: Bei wem irrt sie, wer trägt die Folgen und kann eine betroffene Person widersprechen?
Die unsichtbare Infrastruktur: Chips, Rechenzentren, Menschen und Strom
Wenn ein Chatbot in Sekunden antwortet, wirkt der Vorgang schwerelos. Tatsächlich laufen die Berechnungen auf physischen Servern in Rechenzentren. Für große Modelle werden spezialisierte Chips parallel eingesetzt. Sie benötigen Strom; weitere Energie fließt in Kühlung, Datenspeicherung und Netzwerktechnik.
Das Training eines großen Grundmodells ist besonders rechenintensiv, aber nicht der einzige Verbrauch. Wird ein Modell millionenfach genutzt, summiert sich auch die Inferenz. Die Internationale Energieagentur meldete für 2025 einen weltweiten Anstieg des Stromverbrauchs von Rechenzentren um 17 Prozent; bei KI-orientierten Rechenzentren fiel der Zuwachs noch deutlich höher aus. Gleichzeitig verbessern sich Chips und Modelle, sodass einzelne Berechnungen effizienter werden können. Wie sich beides insgesamt auswirkt, hängt von Effizienz, Nutzungswachstum, Modellgröße und Anwendung ab.
Zur Infrastruktur gehören außerdem Menschen: Sie wählen und bereinigen Daten, schreiben Beispielantworten, kennzeichnen Bilder, bewerten Modellreaktionen, testen Sicherheitsgrenzen und moderieren problematische Inhalte. „Automatisierung“ bedeutet daher nicht, dass zuvor keine menschliche Arbeit nötig war. Häufig wird sie nur an andere Stellen der Produktionskette verlagert.
Was eine KI nicht automatisch kann
- Wahrheit erkennen: Sprachliche Sicherheit ist kein Beweis.
- Aktuell sein: Ohne Suche oder angeschlossene Datenquelle kennt ein Modell Ereignisse nach seinem Trainingsstand nicht zuverlässig.
- Verantwortung übernehmen: Eine Maschine kann keine moralische oder rechtliche Verantwortung anstelle der handelnden Menschen tragen.
- Die Absicht des Nutzers erraten: Unklare Eingaben führen leicht zu unpassenden Ergebnissen.
- Jede Aufgabe gleich gut lösen: Ein Modell kann brillant formulieren und zugleich an einer einfachen Detailfrage scheitern.
- Quellen garantieren: Ohne überprüfbare Belege können Literaturangaben erfunden oder verwechselt sein.
- Privatsphäre von selbst schützen: Vertrauliche Daten gehören nur in Systeme, deren Regeln und Freigaben dies erlauben.
Wie man KI sinnvoll nutzt: sieben einfache Regeln
- Aufgabe und Ziel genau nennen. Kontext, gewünschtes Format und Grenzen verbessern die Antwort.
- Ergebnis als Entwurf behandeln. Besonders Texte wirken oft fertiger, als sie sachlich sind.
- Wichtige Fakten unabhängig prüfen. Quellen öffnen, Zitate im Original suchen und Zahlen nachrechnen.
- Nach Unsicherheit fragen – aber ihr nicht blind vertrauen. Auch eine Einschätzung der eigenen Sicherheit kann falsch sein.
- Geeignete Werkzeuge verlangen. Für aktuelle Informationen braucht das System Suche, für exakte Berechnungen einen Rechner und für interne Fakten eine freigegebene Datenquelle.
- Keine Geheimnisse eingeben. Gesundheitsdaten, Passwörter, Geschäftsgeheimnisse oder personenbezogene Informationen nur in ausdrücklich dafür freigegebenen Systemen verarbeiten.
- Die Folgen berücksichtigen. Je größer der mögliche Schaden, desto wichtiger sind menschliche Prüfung, dokumentierte Quellen und klare Verantwortlichkeit.
Wie funktioniert KI? Die kurze Antwort
Heutige KI-Systeme lernen aus vielen Beispielen, indem ein Trainingsverfahren sehr viele interne Zahlenwerte verändert. Diese Parameter bilden statistische Beziehungen ab. Bei einer neuen Eingabe nutzt das fertige Modell diese Beziehungen, um eine passende Ausgabe zu berechnen.
Ein großes Sprachmodell zerlegt Text in Tokens, verarbeitet deren Beziehungen mit einem Transformer und erzeugt seine Antwort schrittweise als Folge wahrscheinlicher Fortsetzungen. Zusätzliche menschliche Rückmeldungen machen daraus einen brauchbareren Assistenten; Suchmaschinen, Datenbanken und andere Werkzeuge können seine Fähigkeiten erweitern.
Das Ergebnis kann wie ein Gespräch mit einem verstehenden Gegenüber wirken. Unter der Oberfläche bleibt es eine Berechnung. Gerade diese Kombination macht die Technik so faszinierend und so tückisch: Ein System muss kein Mensch sein, um nützlich zu sein. Und es muss nicht wissen, dass es irrt, um uns mit großer Überzeugung in die Irre zu führen.
Kleines KI-Wörterbuch
- Algorithmus
- Eine festgelegte Folge von Rechenschritten zur Lösung einer Aufgabe.
- Maschinelles Lernen
- Verfahren, bei denen ein System Muster aus Beispieldaten lernt, statt nur vollständig ausgeschriebene Einzelfallregeln zu befolgen.
- Modell
- Die trainierte mathematische Struktur, die aus einer Eingabe eine Ausgabe berechnet.
- Parameter
- Während des Trainings angepasste Zahlenwerte im Modell.
- Neuronales Netz
- Ein Modell aus vielen verbundenen Recheneinheiten und Schichten.
- Token
- Eine kleine Texteinheit, etwa ein Wort, Wortteil oder Satzzeichen.
- Transformer
- Eine Modellarchitektur, die Beziehungen zwischen Bestandteilen einer Eingabe besonders wirksam verarbeitet.
- Training
- Der Vorgang, bei dem die Parameter anhand vieler Beispiele eingestellt werden.
- Inferenz
- Die Nutzung des trainierten Modells für eine neue Eingabe.
- Halluzination oder Konfabulation
- Eine plausibel formulierte, aber sachlich falsche oder unbelegte Ausgabe.
Quellen und weiterführende Dokumente
- OECD.AI: How artificial intelligence works
- Google Machine Learning Crash Course: Introduction to Large Language Models
- Google Machine Learning Crash Course: Training with backpropagation
- Vaswani et al.: Attention Is All You Need
- Ouyang et al.: Training language models to follow instructions with human feedback
- Ho, Jain und Abbeel: Denoising Diffusion Probabilistic Models
- NIST: Generative Artificial Intelligence Profile
- Google Machine Learning Crash Course: Fairness
- Internationale Energieagentur: Key Questions on Energy and AI
Quellen
- OECD.AI – How artificial intelligence works
- Google Machine Learning Crash Course – Introduction to Large Language Models
- Google Machine Learning Crash Course – Training using backpropagation
- Vaswani et al. – Attention Is All You Need
- Ouyang et al. – Training language models to follow instructions with human feedback
- Ho, Jain and Abbeel – Denoising Diffusion Probabilistic Models
- NIST – Artificial Intelligence Risk Management Framework: Generative Artificial Intelligence Profile
- Google Machine Learning Crash Course – Fairness
- International Energy Agency – Key Questions on Energy and AI
Redaktioneller Hinweis: Fach- und Quellenstand: 25.09.2026. Der Artikel erklärt verbreitete Grundprinzipien heutiger Systeme. Konkrete Produkte können andere Architekturen, Trainingsverfahren, Datenquellen und Werkzeuge kombinieren. Aussagen über Bewusstsein werden bewusst vom beobachtbaren Leistungsvermögen getrennt.